summarizedfilings.com · 2025
Summarized Filings - raporty SEC, zmiany i AI
Platforma analizy raportów spółek: podsumowania sekcji, wykrywanie zmian i odpowiedzi AI oparte na treści dokumentów.
Odwiedź stronę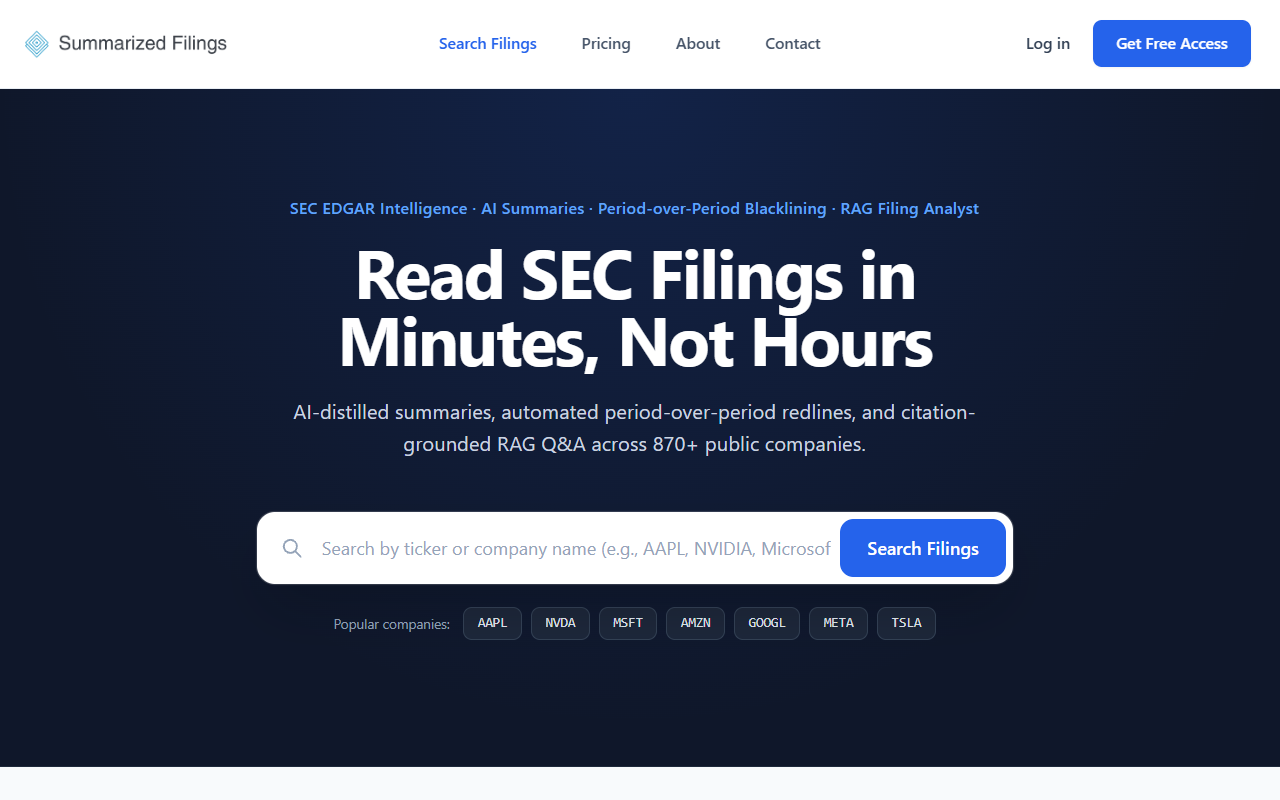
Wyzwanie
Raporty spółek potrafią liczyć setki stron, a istotne aktualizacje giną w powtarzanych informacjach. Inwestor potrzebuje zrozumieć raport, zobaczyć zmiany i zbadać wybrany temat bez otwierania każdego dokumentu osobno.
Rozwiązanie
Dla klienta stworzyliśmy aplikację z wyszukiwarką spółek, czytnikiem dokumentów, podsumowaniami sekcji, porównaniami okresów i stroną Ask AI. Interfejs w React współpracuje z API w Django oraz automatycznym przetwarzaniem raportów SEC, rozbudowanym o wyszukiwanie semantyczne i RAG.
Czytaj zmiany, zachowaj kontekst
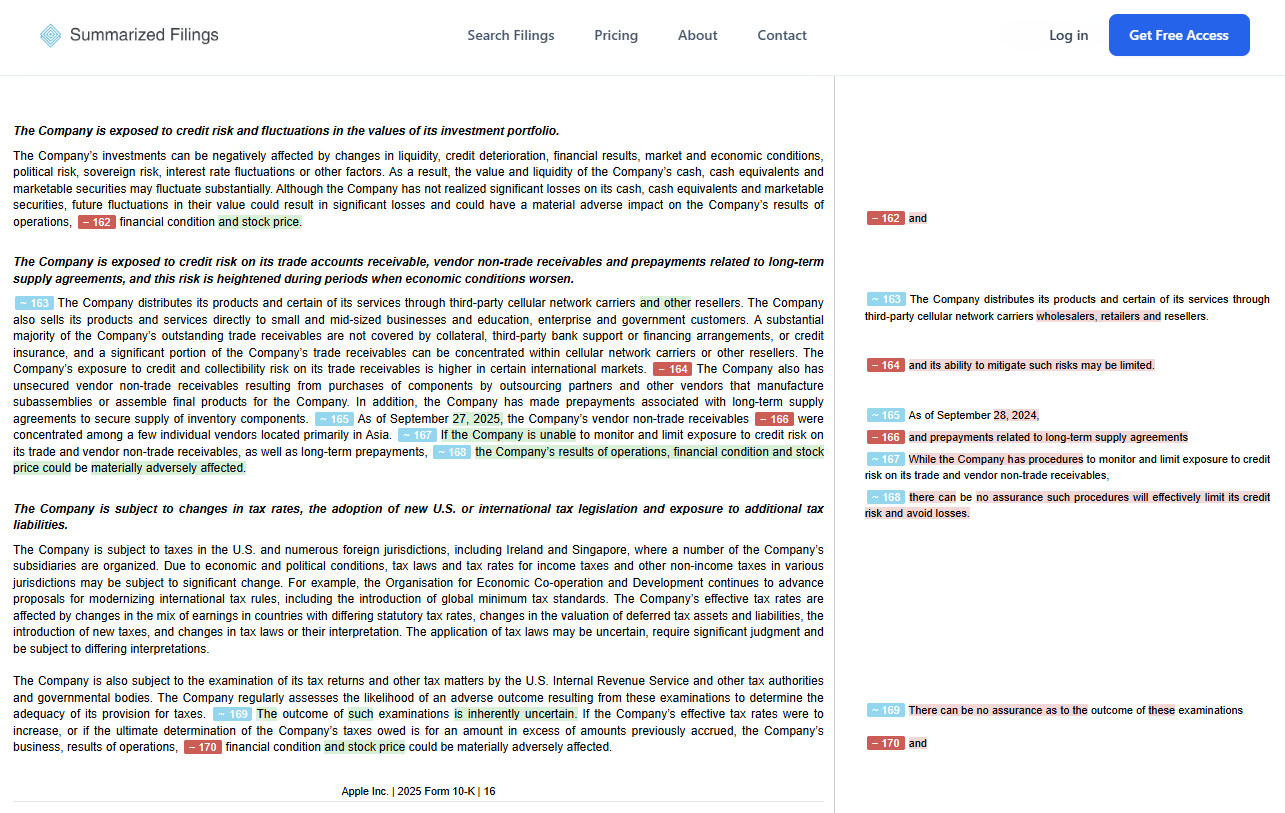
Raporty są dzielone na sekcje, bloki tekstu i tabele z własnymi identyfikatorami. Ta struktura służy zarówno podsumowaniom, jak i porównywaniu zmian, czyli blackliningowi. System dopasowuje sekcje kolejnych raportów rocznych lub kwartalnych i zaznacza dodaną oraz usuniętą treść. Czytelnik może skupić się na nowych informacjach, zachowując wgląd w oryginał.
Wyszukiwanie po znaczeniu, odpowiedzi ze źródeł
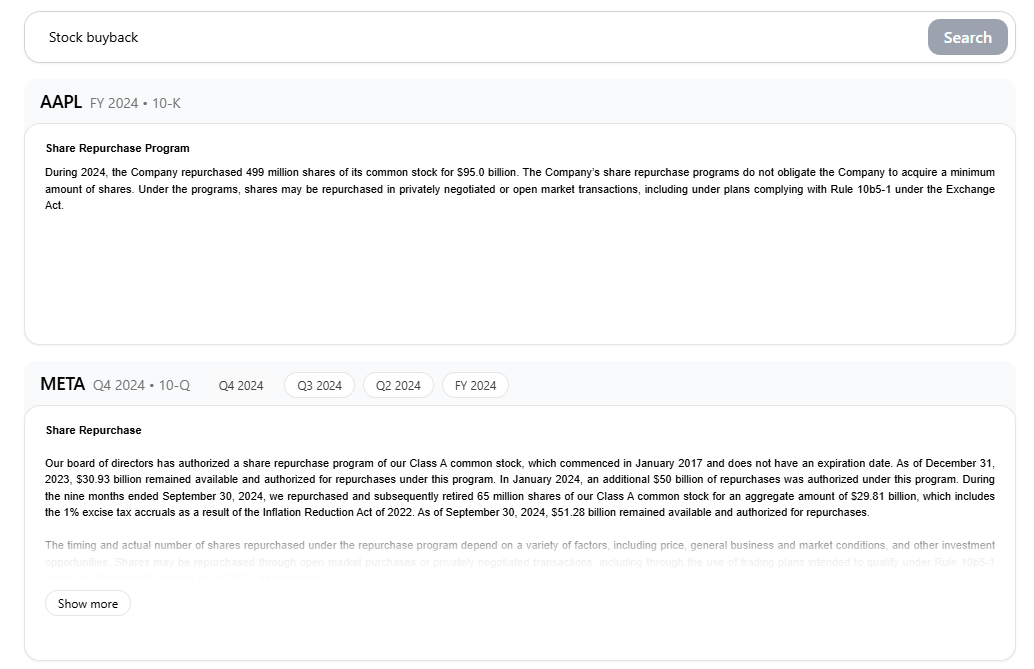
Zapytanie 'stock buyback' może odnaleźć fragmenty o 'share repurchases', mimo innego sformułowania tego samego pojęcia. Wyniki można zawęzić do spółki, roku i typu raportu. RAG (generowanie odpowiedzi wspomagane wyszukiwaniem) przekazuje znalezione sekcje jako kontekst opcjonalnej odpowiedzi AI, zamiast wysyłać modelowi całe dokumenty. Testowany proces obsługuje też brak wystarczającego kontekstu i pytania niezwiązane z raportami, zwracając jasne komunikaty.
Ciężka praca odbywa się przed zapytaniem
AWS Step Functions, SQS i Lambda przygotowują embeddingi w tle, z kontrolą współbieżności, ponowieniami i kolejką błędów. PostgreSQL z pgvectorscale wyszukuje podobne fragmenty na podstawie wektorów o 1024 wymiarach. Oryginalne sekcje HTML trafiają osobno do DynamoDB, a zbyt duże dane do S3. Wspólne identyfikatory łączą każdy wektor ze źródłem, umożliwiając niezależne skalowanie wyszukiwania i przechowywania treści.
Efekty
- →Ewaluacja z grudnia 2025: około 95 ms wykonania zapytania w bazie dla 20 najlepszych dopasowań spośród około 1,5 mln wektorów.
- →Osobny pomiar całego wyszukiwania: około 3,7 s od wysłania zapytania do pobrania sekcji, bez generowania odpowiedzi AI.
- →Dziewięć ręcznych scenariuszy testowych zakończonych powodzeniem. Do wykonania pozostał test recall względem dokładnego wyszukiwania najbliższych sąsiadów.
- →Wstępne rozmowy z czterema inwestorami indywidualnymi wskazały większą wartość wykrywania zmian niż wyszukiwania semantycznego, pomagając postawić blacklining w centrum produktu.